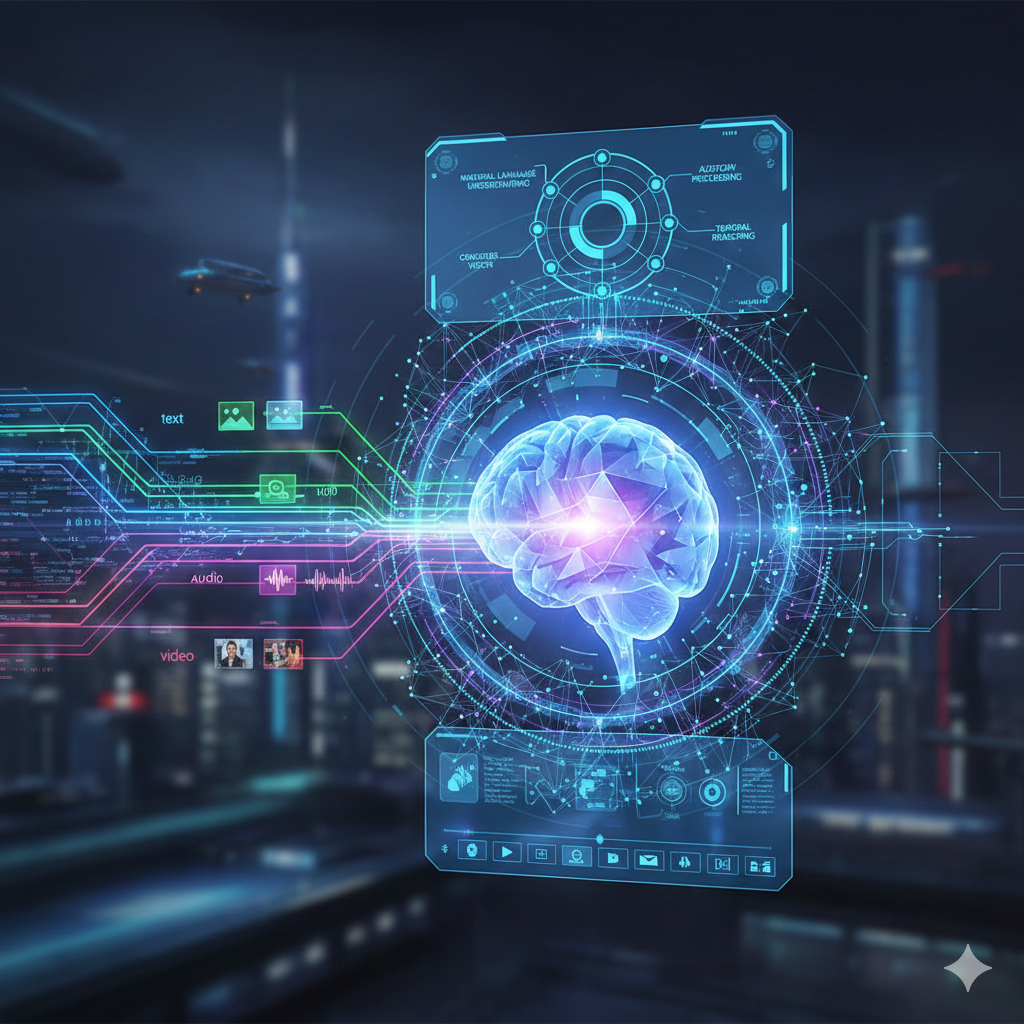
يشهد العالم التقني اليوم تحولًا جذريًا في قدرات الذكاء الاصطناعي، تقوده فئة جديدة من النماذج تُسمى النماذج متعددة الوسائط (Multimodal AI). هذه النماذج لا تعتمد على النص وحده، بل تستطيع فهم وتحليل وتوليد النص والصوت والصورة والفيديو والبيانات الحسية داخل نموذج واحد، مما يجعلها أقرب ما تكون إلى طريقة معالجة الإنسان للمعلومات.
لم يعد الذكاء الاصطناعي مجرد روبوت محادثة، بل أصبح منظومة إدراك كاملة قادرة على التفاعل مع العالم بطرق غير مسبوقة. وفي هذا المقال، نستعرض بشكل شامل ودقيق ماهية هذه النماذج، كيف تعمل، أبرز تطبيقاتها، أهم النماذج العالمية، ولماذا تُعد مستقبل التقنية خلال السنوات القادمة.
ما هي النماذج متعددة الوسائط؟
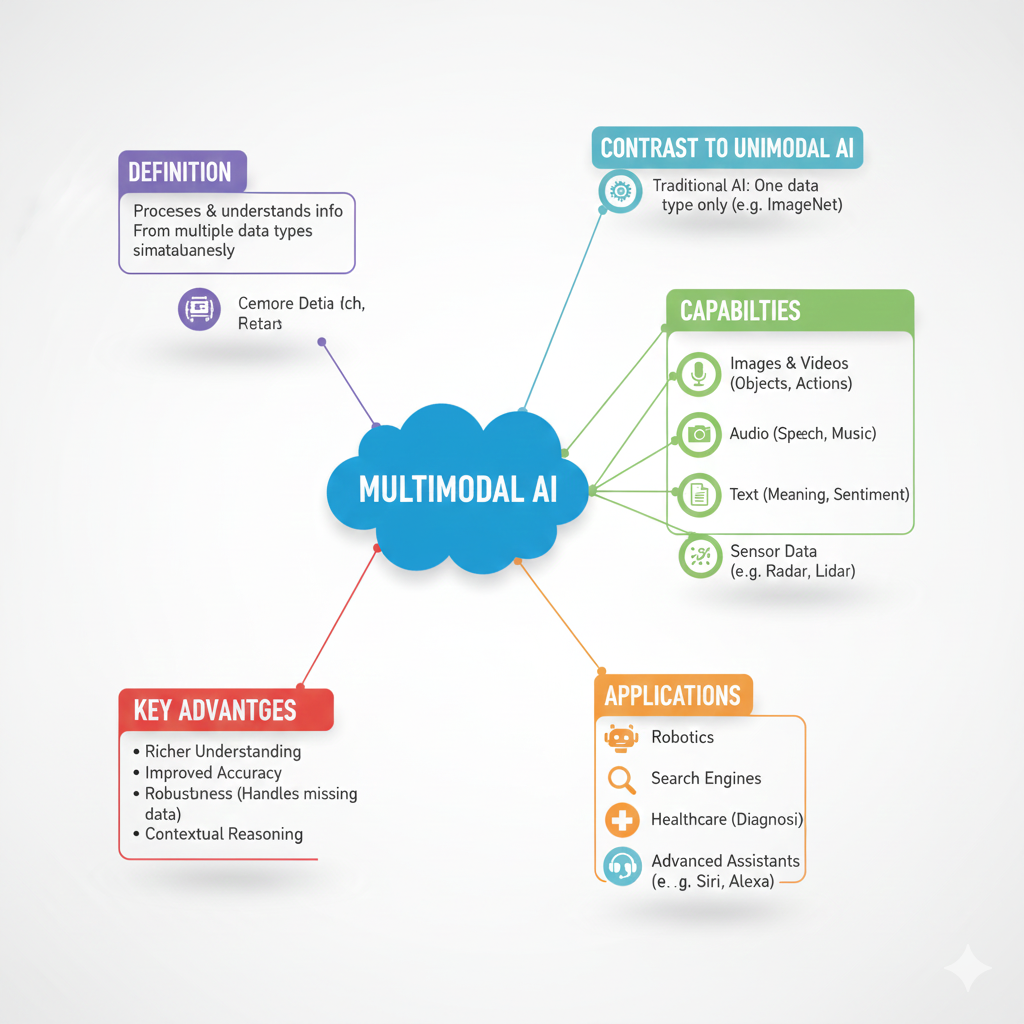
النموذج متعدد الوسائط هو نظام ذكاء اصطناعي يمكنه التعامل مع أكثر من نوع واحد من البيانات في وقت واحد. على سبيل المثال، يستطيع النموذج أن:
- يقرأ نصًا
- يحلل صورة
- يفهم صوتًا
- يفسر فيديو كامل
- يستخرج معلومات من ملفات متنوعة
ثم يجمع كل هذا داخل سياق واحد ويصدر نتيجة دقيقة.
هذا التطور يمثل قفزة كبيرة مقارنة بالنماذج القديمة التي كانت تعتمد على “مدخل واحد” فقط مثل نص أو صورة.
رسم يوضح مفهوم النماذج متعددة الوسائط وكيفية دمج النص والصوت والصورة والفيديو داخل نموذج ذكاء اصطناعي واحد.
كيف تعمل النماذج متعددة الوسائط؟
تعتمد هذه النماذج على تقنيات معقدة أهمها:
1) محولات متعددة الوسائط (Multimodal Transformers)
وهي بنية عصبية تسمح للنموذج بتحليل أشكال مختلفة من البيانات ثم دمجها في “تمثيل موحد”.
2) طبقات فهم السياق
النموذج لا ينظر للصورة فقط، بل يفهم سياقها:
ما الذي يحدث؟ من في الصورة؟ كيف تتعلق الكلمات بالمشهد؟
3) نماذج تدريب هائلة
تعتمد الشركات على تدريب هذه النماذج على:
- ملايين الصور
- آلاف الساعات من الفيديو
- تسجيلات صوتية
- قواعد بيانات نصية ضخمة
ليتمكن الذكاء الاصطناعي من تكوين “رؤية شمولية” للعالم.
لماذا تُعد هذه النماذج أهم ثورة في تاريخ الذكاء الاصطناعي؟
1) تقارب قدرات الذكاء الاصطناعي مع الإدراك البشري
الإنسان يتفاعل مع العالم عبر السمع والبصر واللغة…
وهذا يجعل الذكاء الاصطناعي متعدد الوسائط أقرب لطريقة تفكير البشر.
2) قدرات جديدة لم تكن ممكنة سابقًا
مثل:
- تحليل فيديو كامل واستخراج أهم الأحداث
- فهم مشاعر المتحدث من صوته
- قراءة الوثائق والصور الممسوحة ضوئيًا
- فهم الواقع عبر كاميرا الهاتف
3) إنهاء عصر “النموذج المتخصص”
لم تعد تحتاج نموذجًا للصور وآخر للنصوص…
نموذج واحد يكفي للقيام بكل شيء.
أبرز النماذج متعددة الوسائط عالميًا (2025-2026)
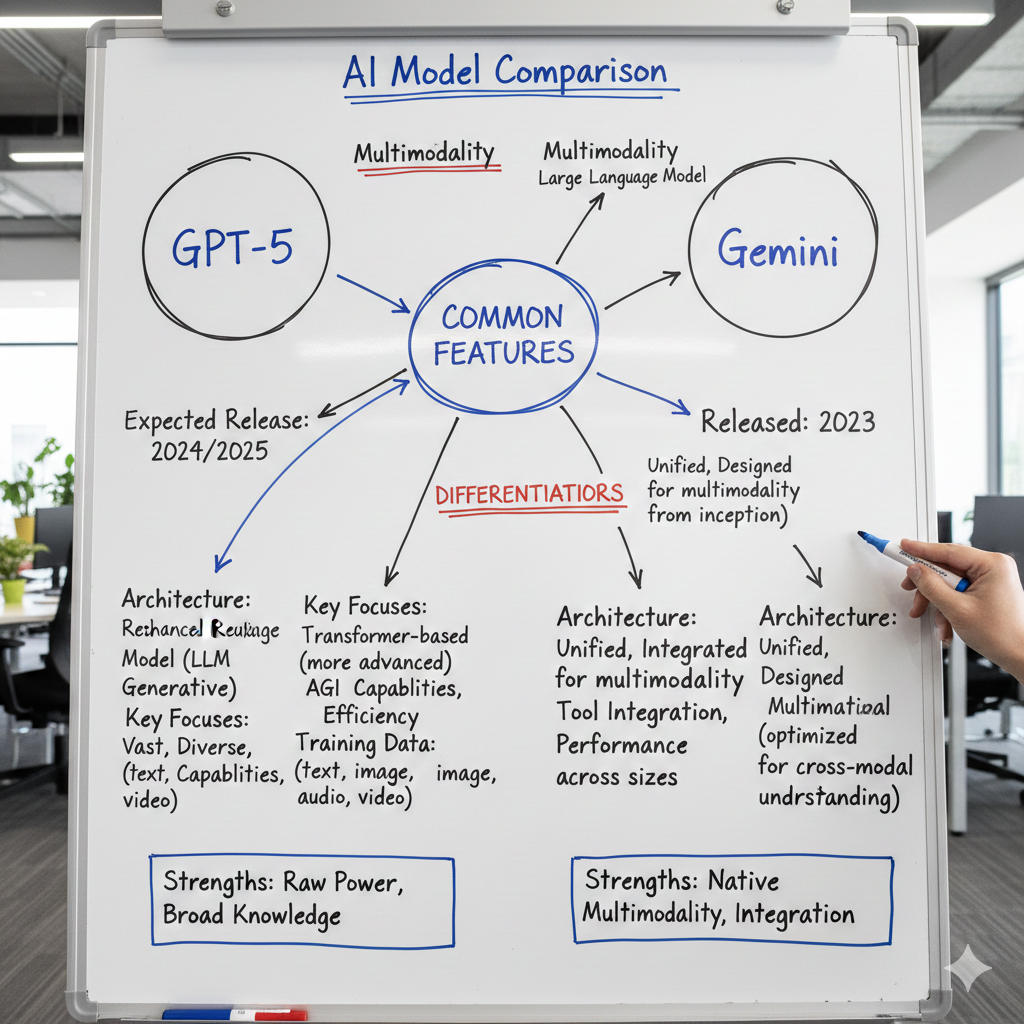
1) GPT-5 و GPT-4.1 Omni – OpenAI
نموذج قادر على:
- تحليل صور عالية الدقة
- كتابة نصوص عميقة
- فهم صوت طبيعي
- مشاهدة فيديو وتحليل محتواه
ويُعد من أقوى النماذج في الدمج بين الوسائط.
2) Google Gemini 2.0 Ultra
أحد أكثر النماذج تطورًا في التعامل مع الفيديو والبيانات البصرية.
يتميز بقدرته على تحليل ساعات من المحتوى دفعة واحدة.
3) Claude 3.7 – Anthropic
يشتهر بذكائه اللغوي العالي جدًا وقدرته على تفسير البيانات بشكل منطقي ومنهجي.
4) Luma & Runway Gen-3
نماذج تركّز على ذكاء الفيديو: توليد مشاهد واقعية وتحريك العناصر بدقة عالية.
أهم استخدامات Multimodal AI اليوم
1) التعليم الذكي
شرح الفيديوهات، تبسيط الدروس، تحويل النصوص إلى رسوم مرئية.
2) الصحة
تحليل الأشعة، قراءة التقارير الطبية، فهم كلام الطبيب والمريض معًا.
3) الأمن السيبراني
تحليل سلوكيات الهجمات، قراءة سجلات الشبكات، فهم محتوى صورة أو فيديو مرتبط بجريمة إلكترونية.
4) الإعلام وصناعة المحتوى
إنشاء فيديوهات، تعديل صور، كتابة سكربتات… كلها داخل نظام واحد.
5) الأعمال
تحليل عروض بوربوينت، قراءة العقود، استخراج البيانات من الملفات.
إلى أين يتجه المستقبل؟
كل المؤشرات تقول إن السنوات القادمة ستشهد:
- نماذج قادرة على استخدام الحواس الخمس افتراضيًا
- ذكاء اصطناعي يفهم العالم الحقيقي عبر الكاميرا
- أدوات تصنع أفلامًا كاملة من جملة نصية واحدة
- مساعدين شخصيين يديرون أعمال كاملة بدون تدخل بشري
النماذج متعددة الوسائط ليست مرحلة مؤقتة، بل أساس الجيل القادم من كل أدوات الذكاء الاصطناعي.
الخلاصة
النماذج متعددة الوسائط تمثل ثورة جديدة في الذكاء الاصطناعي، لأنها توحّد الفهم البصري واللغوي والصوتي داخل نموذج واحد. ومع التطور السريع لهذه التقنيات، سيصبح الذكاء الاصطناعي جزءًا أساسيًا من كل صناعة، من التعليم والصحة إلى الأمن السيبراني والإعلام.
هذه ليست مجرد خطوة تطويرية… إنها قفزة نحو ذكاء يشبه العقل البشري أكثر من أي وقت مضى.
Pingback: الذكاء الاصطناعي التوليدي… بوابة الجيل القادم من الذكاء الاصطناعي. - CyberTeech.com